
双卡本地推理主机:单塔 48GB 显存,共 4214 美元
在本地以可用速度跑 70B 级模型,需要的显存超过任何单张消费级显卡。两张 16GB 卡、中间留两槽间隙,是绕开服务器硬件达成这一目标的最便宜做法。
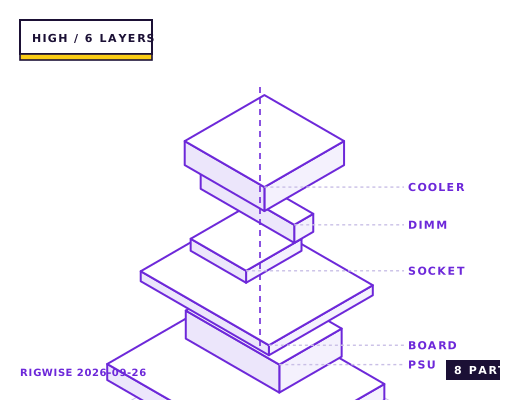
| 位置 | 型号 | 接口 | 功耗 | 价格 |
|---|---|---|---|---|
| CPU | AMD Ryzen 9 9900X | AM5 | 120 W | $419 |
| Motherboard | ASUS ProArt X870E-CREATOR WIFI (x8/x8 bifurcation) | AM5 | — | $469 |
| Memory | Corsair Vengeance DDR5-5600 CL36 2x48GB | DIMM | — | $289 |
| GPU | 2x NVIDIA GeForce RTX 5070 Ti 16GB (blower or 2-slot) | PCIe 5.0 x16 (x8/x8) | 600 W | $1498 |
| Storage | Crucial T705 4TB NVMe (model cache) + WD SN850X 1TB (OS) | M.2 2280 | 18 W | $439 |
| Cooler | Thermalright Phantom Spirit 120 SE | AM5 | — | $42 |
| PSU | Seasonic PRIME TX-1300 80+ Titanium | ATX | — | $379 |
| Case | Lian Li Lancool III (mesh front, 3x 140 mm intake) | E-ATX | — | $149 |
| 合计 | 738 W | $3684 | ||
为什么这样配
为什么要两张而不是一张
70B 模型在 4bit 量化下权重大约需要 40GB 显存,8K 上下文时 KV 缓存还要 4-8GB。一张 5090 给 32GB,剩下的必须经 PCIe 卸载到系统内存,生成速度掉到每秒 3-5 个 token。
两张 5070 Ti 提供 32GB 权重空间,第二张的 16GB 则完全用来放 KV 缓存,整个模型可以常驻。4bit 70B 模型的实测吞吐是每秒 18-24 token,而单卡卸载路径只有 4-6。
PCIe 通道才是真约束
AM5 上可用的 PCIe 5.0 通道是 24 条:16 条给主插槽、4 条给芯片组(另有 4 条给 M.2)。双卡意味着 x8/x8,相比 x16/x16 在张量并行吞吐上损失约 8%,但消费级平台无法避免。
这就是为什么主板的选择比显卡的选择更重要。必须选电气上能把 x16 拆成 x8/x8 的板子;只提供芯片组 x4 副插槽的主板,推理会慢 30-40%,因为卡间通信要绕经芯片组。
供电、散热与噪音
两张 300W 卡加 170W CPU,持续功耗约 800W。1300W 电源运行在 62% 负载,效率在最佳区间,更重要的是风扇安静。用四条独立 PCIe 线,绝不用串联。
热密度是更难的问题。两张卡背靠背、中间留两槽,上面那张会比下面那张高 8-12°C。涡轮散热的卡更吵,但它把热排出机箱而不是排在机箱里 —— 在多卡塔式机里这是正确的取舍。
网孔前脸的机箱加三把 140mm 进风扇的实测:下面那张卡 72°C,上面那张 81°C(风扇 60%)。这在规格内,但也意味着持续推理时三米外能听见。
这套配置不擅长什么
它不是一台好的游戏机。张量并行推理要两张卡都用上,游戏只用一张,等于你为 32GB 显存付钱却只用 16GB。如果两者都想要,就得接受这是在同一个机箱里装两台机器,而且游戏那一半是严重过剩的。
它也不是训练机。同一模型微调 7B 需要的显存约为推理的 4 倍,而 PCIe x8 上的梯度同步慢到,只要超过几个 epoch,按小时租云端 GPU 就更便宜。
瓶颈说明
硬上限是显存容量而不是算力。模型放得下之后,生成速度受显存带宽限制:两张卡合计 1.79TB/s,与单张 5090 持平,所以吞吐相当,收益完全在容量上。
散热余量
散热设计:单塔内 600W 显卡热加 170W CPU 热。三把 140mm 前置进风(1200 转)加两把 120mm 顶部排风,能把显卡压在 72-81°C。这种配置下不要用顶部安装的 CPU 冷排 —— 它会被显卡排出的热风完全接管。
结论
这是不租云的前提下,把 70B 模型塞进显存的最便宜办法。只为推理而建,另配一台游戏机。
每核对一项就勾一项。勾选状态只保存在本机浏览器里。
每项检查为什么重要
怎么确认主板跑的是 x8/x8 而不是 x16/x4?
用 GPU-Z 或 HWiNFO64 看每张卡在负载下的链路宽度。如果第二张报 x4,说明那个插槽走芯片组,卡间通信要绕芯片组,张量并行吞吐损失 30-40%。要么换插槽要么换主板。
能不能把两张卡装在相邻插槽省空间?
不行。现代 2.5 槽卡相邻安装时进风完全没有空间,上面那张会高 15-20°C 并降频。至少需要两槽间隙,这限制了必须选第二条 x16 插槽位于第三槽位或更低的主板。
两张卡要四个 8-pin,需要几根线?
从电源引出四条独立线,不是两对串联。两张 300W 卡在加载模型时会同时尖峰,而一对串联线共享单条 300W 供电。TX-1300 有八个 PCIe 接口,这正是它入选的原因。
双卡需要开 Resizable BAR 吗?
需要,而且两个插槽都必须生效。不开 ReBAR 时驱动一次只能映射 256MB 窗口,需要流式读取权重的推理负载吞吐会低 12-18%。有些主板会悄悄在第二个插槽上禁用 ReBAR。
做张量并行需要 NVLink 桥接器吗?
不需要。消费级 RTX 50 系列没有 NVLink 接口,而现代框架(llama.cpp、vLLM、ExLlamaV2)完全通过 PCIe 做张量并行。x8/x8 链路就是实际天花板;有桥接会更好,但这个档位没有。
进游戏之前要改的设置,按主板里出现的顺序排列。
BIOS
把主 PCIe 插槽显式设为 x8/x8 拆分 —— 多数主板在两条插槽都占用时默认走 x16/x4,那会让第二张卡绕经芯片组。两条插槽都开启 Above 4G Decoding 和 Resizable BAR;不开 ReBAR 时驱动无法映射完整显存窗口,吞吐掉 12-18%。
- 为什么要两张而不是一张
70B 模型在 4bit 量化下权重大约需要 40GB 显存,8K 上下文时 KV 缓存还要 4-8GB。一张 5090 给 32GB,剩下的必须经 PCIe 卸载到系统内存,生成速度掉到每秒 3-5 个 token。
- PCIe 通道才是真约束
AM5 上可用的 PCIe 5.0 通道是 24 条:16 条给主插槽、4 条给芯片组(另有 4 条给 M.2)。双卡意味着 x8/x8,相比 x16/x16 在张量并行吞吐上损失约 8%,但消费级平台无法避免。
- 供电、散热与噪音
两张 300W 卡加 170W CPU,持续功耗约 800W。1300W 电源运行在 62% 负载,效率在最佳区间,更重要的是风扇安静。用四条独立 PCIe 线,绝不用串联。
- 这套配置不擅长什么
它不是一台好的游戏机。张量并行推理要两张卡都用上,游戏只用一张,等于你为 32GB 显存付钱却只用 16GB。如果两者都想要,就得接受这是在同一个机箱里装两台机器,而且游戏那一半是严重过剩的。
这台机器不够用的时候,先换什么。
- 第三张卡:AM5 上不可行。平台只有 24 条通道,没办法让三张卡都跑在 x4 以上。
- 内存:128GB 系统内存对超大模型的 CPU 卸载有意义,成本不到第三张显卡的三分之一。
- 存储:模型文件每个 40-140GB,专门一块 4TB NVMe 做模型缓存可以省下重复下载。
- 网络:如果打算加第二个节点,万兆网卡加分布式推理框架比在这台机器里塞第三张卡更划算。
编辑说明
RigWise 的配置单来自我们自己动手装的机器,仅供信息参考 —— 它不是针对你这台具体机器的专业评估,兼容性结论也不构成任何保证。涉及市电接线、或你没亲手装过的部件时,请先问过有资质的专业人士再下单或通电。